Kimi K3 一夜打殘費半
但佢比上一代貴咗 3 倍
市場嗌「第二次 DeepSeek 時刻」— 但數字話你知,大家恐慌嘅方向搞錯咗
重點摘要
- Kimi K3:2.8 萬億參數、896 個 expert,每 token 激活 16 個
- 費半收 11,673.89 點,較 6/22 高位低 20.2% 入熊市
- 台積電台北跌 7.29%、輝達跌 2.21%
- K3 定價 $3/$15,input/output 比 K2.6 貴 3.2/3.8 倍
- Artificial Analysis 智能指數 K3 得 57 分,排第三
7 月 17 日凌晨,北京嘅月之暗面(Moonshot AI)冇開發布會、冇預告,直接掟咗個 Kimi K3 出嚟。第二日開市,費城半導體指數收 11,673.89 點、跌 1.63%,較 6 月 22 日紀錄收市價低 20.2%,正式跌入熊市。台積電喺台北插 7.29%、輝達插 2.21%、SoftBank 插約 9%(Fortune 數字,CNBC 報 9.2%),連 Z.ai 喺香港都插咗接近三成。
全世界一致嘅解讀係:第二次 DeepSeek 時刻嚟咗。摩根大通策略師直接用「DeepSeek 2.0」形容,去年嗰次抹咗科技股足足 1 萬億美元市值。
不過從數據嚟睇,呢次嘅劇本其實同上次唔同。K3 唔止唔平,佢仲係中國實驗室歷史上最貴嘅模型 — 定價比自家上一代 K2.6 貴咗超過三倍。市場驚嘅嘢,同真正應該驚嘅嘢,唔係同一件事。
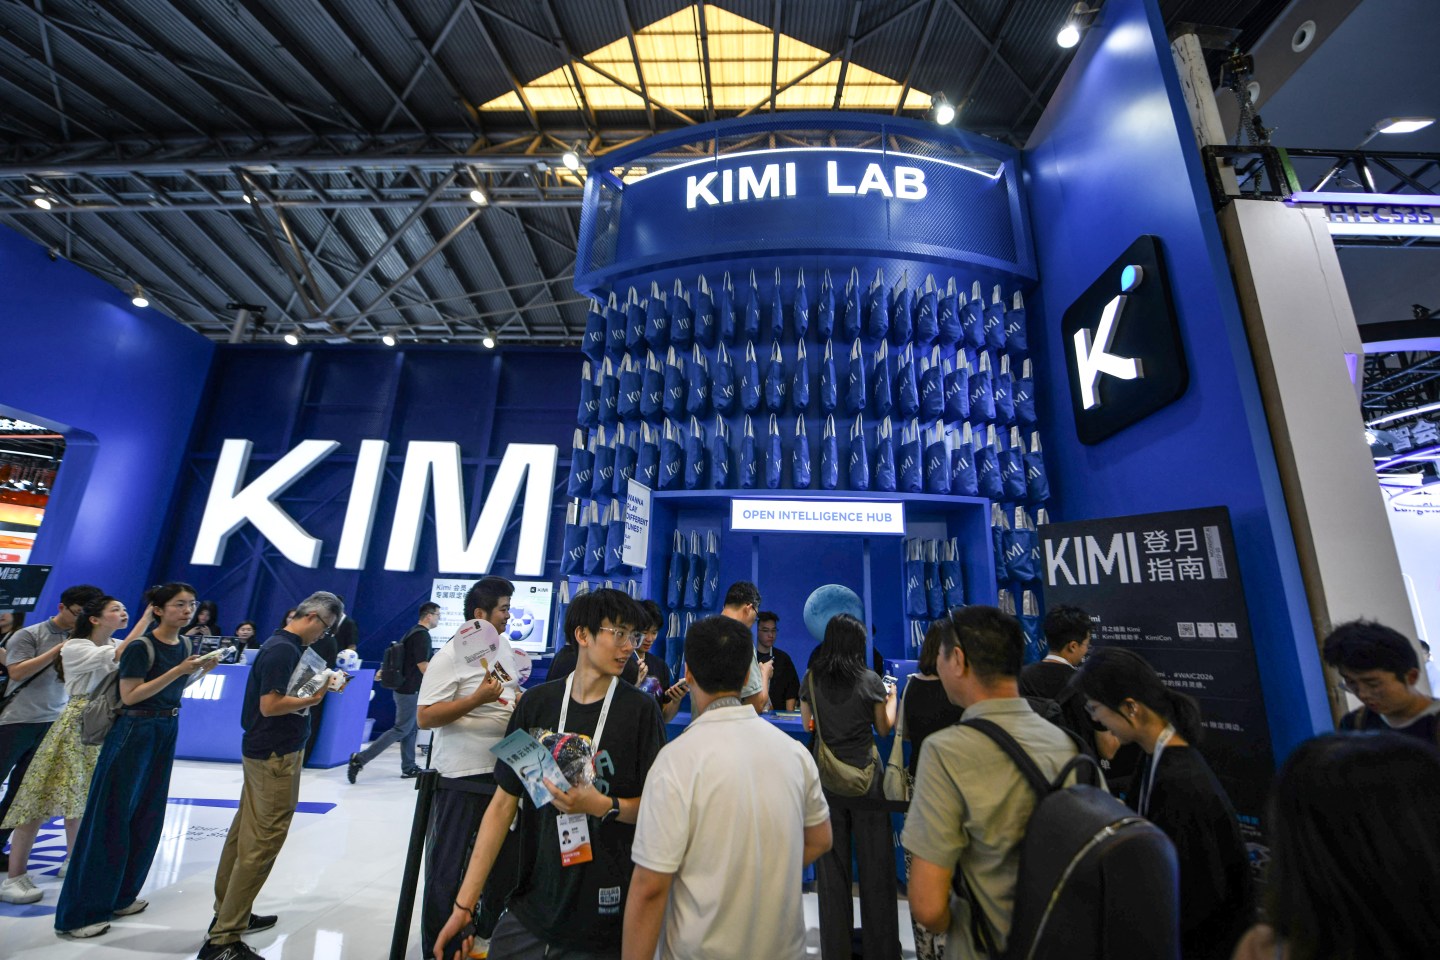
半夜掟個模型出嚟,第二日費半入熊市
時間點好講究。月之暗面揀咗 7 月 16 日夜晚(美國時間)發布,即係話美股 17 日開市前所有人先至消化到。而嗰個星期,半導體板塊本身已經好虛 — 資金一路撤出 AI 資本開支受惠股,已經連續幾個星期。
K3 只係最後一根稻草,但呢根稻草夠重。
最反常識嘅係台積電。佢同日公布嘅第二季業績大幅優於預期,純利按年暴升 77.4% 至 7,065.6 億新台幣,仲上調埋展望 — 照插 7%。
不過呢度有個好多人漏咗嘅細節,而佢正正解釋到點解隻股會跌:嗰 77.4% 係「純利」,唔係「營運利潤」。營運利潤只係符合預期,營運利潤率 60.3%;個超預期嘅部分,主要嚟自出售世界先進(Vanguard)股權嘅一次性收益,大約 632 億新台幣。
換句話講:台積電嘅核心業務冇 beat,靠賣資產先靚仔。而佢同日仲宣布將今年全球資本開支由原本嘅 520–560 億美元,上調到 600–640 億美元(上限計即係加約 14%)。
喺舊敘事之下,capex 上調係鐵一般嘅利好;但 K3 出咗之後,市場即刻反過嚟問:如果中國實驗室用少好多算力都做到接近前沿,咁你哋加碼呢幾百億,幾時先回到本?
換個角度理解:呢日跌得最狠嘅唔係「AI 概念股」,係「AI 資本開支概念股」。Apple 同日一度超越輝達、短暫奪返全球市值第一(收市輝達又反超約 60 億美元)。市場唔係唔信 AI,係開始唔信「AI 一定要燒咁多錢」。
2.8 萬億參數 — 佢究竟係咩怪物
先講清楚規格,因為好多媒體都寫錯。
K3 係一個 2.8 萬億參數嘅稀疏 MoE(混合專家)模型。「稀疏」係關鍵字 — 佢有 896 個 expert 子網絡,但處理每個 token 只會激活其中 16 個,即係大約 1.8%。呢個就係點解佢有 2.8 萬億參數,但唔使真係用 2.8 萬億參數嘅算力去跑。
其他規格:1M token context、原生多模態輸入(文字、圖像同一個架構處理,唔係外掛;輸出仍然係純文字)、完整權重承諾 7 月 27 日前釋出 — 留意 Moonshot 到目前為止仲未公布授權條款,外界估係修改版 MIT,但官方未確認。
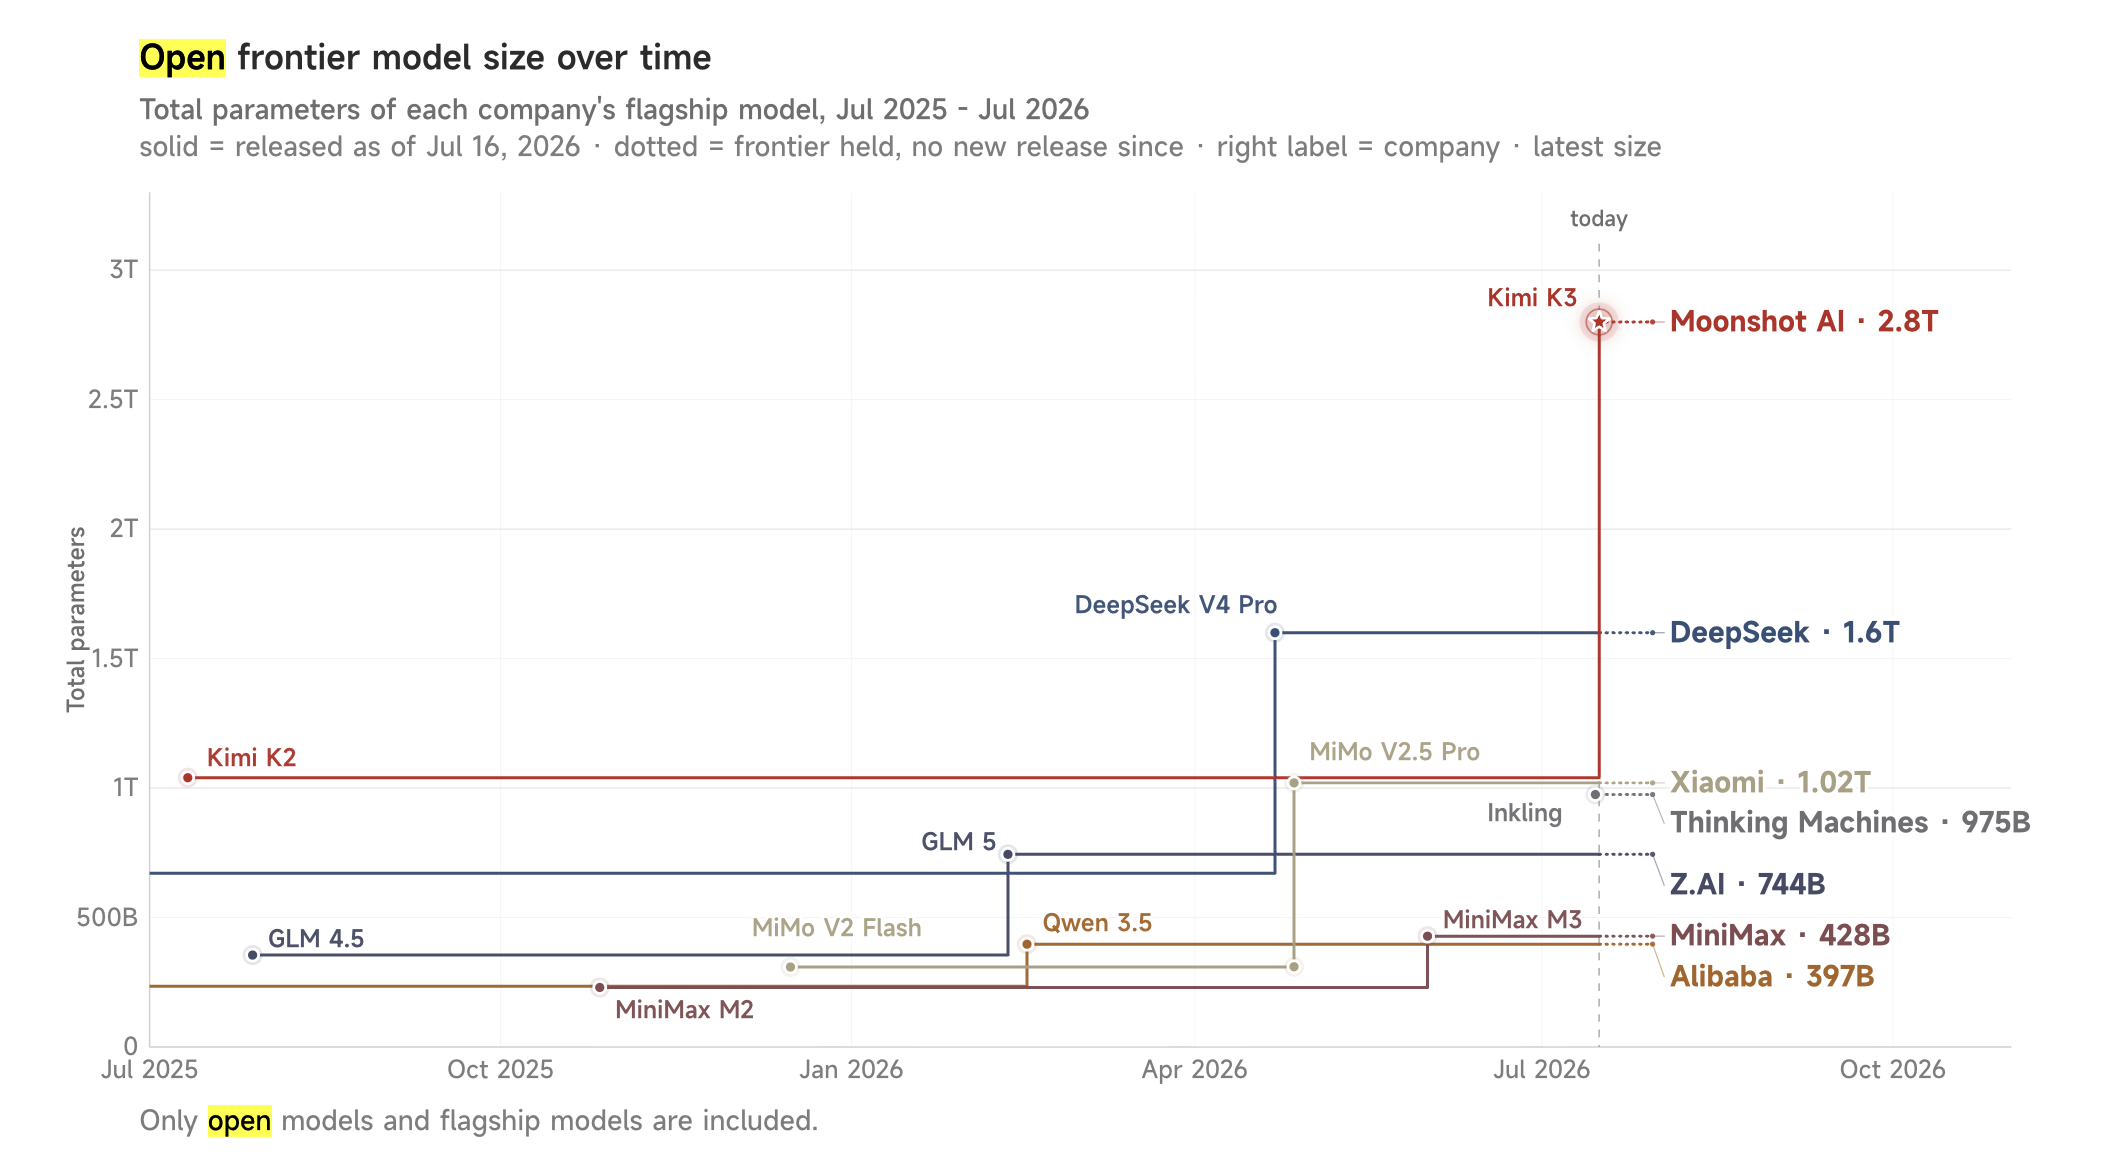
之前個紀錄由 DeepSeek 嘅 V4-Pro(1.6 萬億)保持(美團 LongCat 2.0 同樣係 1.6 萬億),月之暗面自己上代 K2 得 1 萬億。K3 幾乎係最接近嘅開源對手嘅兩倍 — 不過要講清楚,權重未出街之前呢個名銜仍然係「預告」,7 月 27 日先兌現得到。
Moonshot 叫佢做「全球首個開源 3T 級模型」— 2.8 萬億 rounding 上去 3 萬億,marketing 味係濃咗少少,但個 scale 係實。
Moonshot 自己都好坦白:整體表現仍然排喺 Claude Fable 5 同 GPT-5.6 Sol 之後。但喺佢自己嗰套評測入面,K3 贏晒其他所有模型,包括 Claude Opus 4.8 同 GPT-5.5。
兩個真正嘅技術突破 — 唔係堆參數咁簡單
如果 K3 淨係「參數大」,市場唔會咁驚。真正令業界坐直身嘅,係佢點樣用少嘅資源做到呢件事。核心係兩個架構改動。
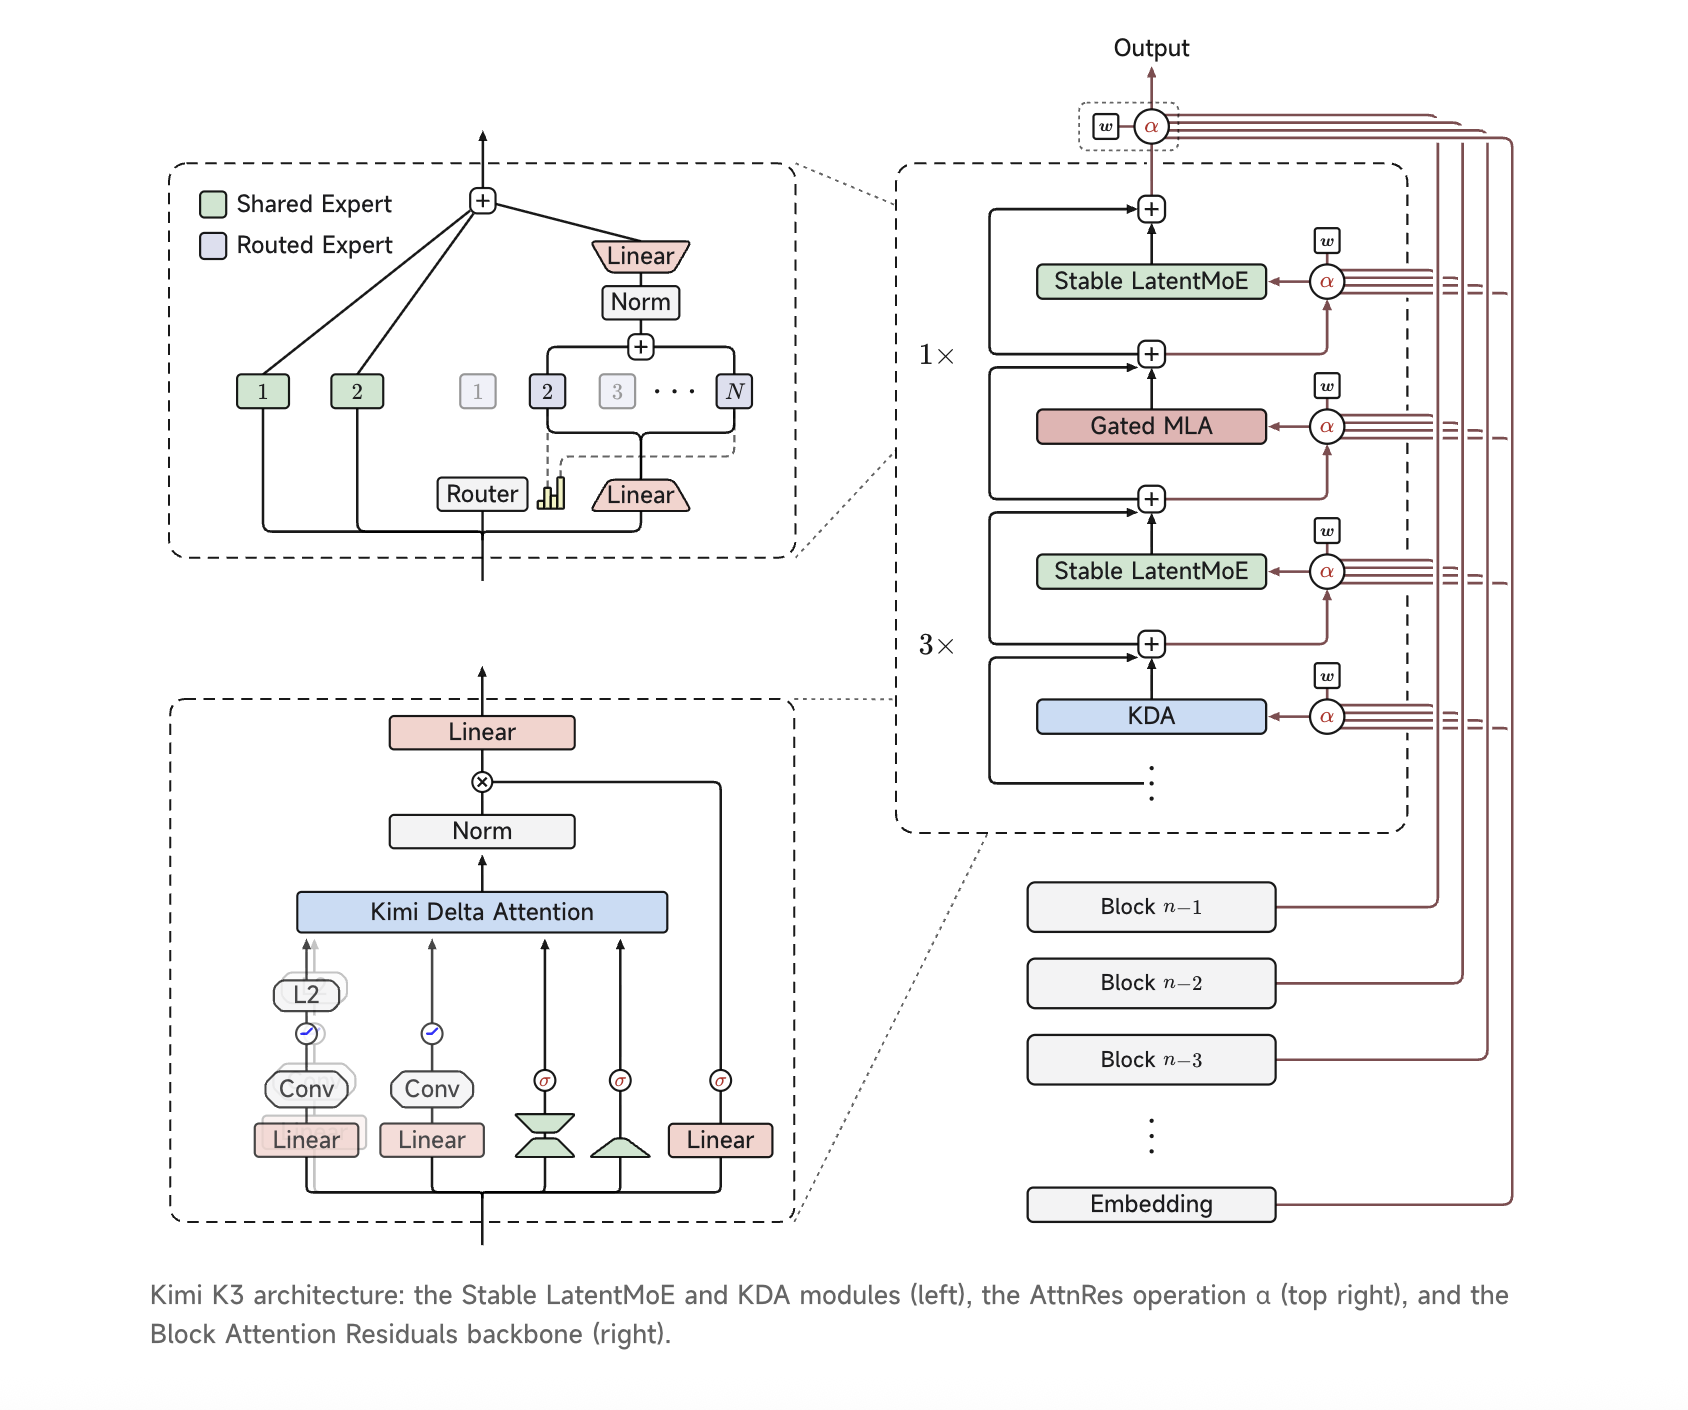
KDA — Kimi Delta Attention
一個混合線性注意力機制,處理「序列長度」呢條軸。官方數字:喺百萬 token context 之下,解碼速度快到 6.3 倍。
意義:長 context 一直係成本殺手,你 context 越長,每個 token 就越貴越慢。KDA 直接打爛呢條曲線 — 呢個先係「長時程 agent 任務」可以商業化嘅前提。
AttnRes — Attention Residuals
處理「模型深度」呢條軸。傳統做法係逐層均勻累積資訊,AttnRes 改成跨層選擇性檢索。
官方數字更加誇張:訓練效率提升約 25%,額外運算成本低於 2%。呢個係接近免費午餐嘅 trade-off。
再加上 Stable LatentMoE、Quantile Balancing(直接由 router 分數嘅分位數推導專家分配,省返一個好敏感嘅超參數)、Per-Head Muon、SiTU、Gated MLA 一堆優化 — 合埋嚟,整體 scaling 效率比 K2 好大約 2.5 倍。
部署方面亦都好見功夫:由 SFT 階段就開始做量化感知訓練(QAT),用 MXFP4 權重配 MXFP8 激活 — Moonshot 明講呢個組合係為咗「廣泛硬件兼容性」。呢句嘢後面有嘢,第 6 章會講。
Benchmark 全表 — 邊度贏,邊度輸
先睇 Moonshot 官方數字(全部用 reasoning effort = max):
| Benchmark | Kimi K3 | Fable 5 | GPT-5.6 Sol | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 | 46.2 |
| Program Bench | 77.8 | 76.8 | 77.6 | 71.9 | 63.7 |
| Terminal Bench 2.1 | 88.3 | 84.6 | 88.8 | 84.6 | 82.7 |
| FrontierSWE | 81.2 | 86.6 | 71.3 | 66.7 | 67.3 |
| SWE Marathon | 42.0 | 35.0 | 39.0 | 40.0 | 13.0 |
| BrowseComp | 91.2 | 88.0 | 90.4 | 84.3 | — |
| Automation Bench | 30.8 | 29.1 | 29.7 | 27.2 | 12.9 |
| GPQA-Diamond | 93.5 | 92.6 | 94.1 | 91.0 | 91.2 |
| HLE-Full | 43.5 | 53.3 | 44.5 | 49.8 | — |
| OmniDocBench | 91.1 | 89.8 | 85.8 | 87.9 | — |
兩個一定要講嘅 caveat:Fable 5 嗰欄係「with fallback」— 被使用政策拒絕嘅請求會自動 route 去 Opus 4.8;而 BrowseComp 用咗 300K token 觸發嘅 context compaction,冇呢個管理嘅話 K3 得 90.4 分。
官方數字梗係要打折。真正有殺傷力嘅係第三方獨立評測:
- Arena.ai 前端程式碼榜:K3 攞 1,679 分排第一,壓過 Fable 5 嘅 1,631 分。七個前端範疇入面贏咗六個。呢個係由 K2.6 嘅第 18 位,一次過跳 17 位。
- Towards AI 寫作 Elo(盲測評分,同國際象棋一樣嘅 Elo 制):K3 攞 2,840,高過 Fable 5(max)嘅 2,760 — 而寫作一直係 Anthropic 嘅主場。由第 21 位跳上第 1 位。
- BridgeBench 頭對頭:K3 對 Fable 5 贏咗 8 個 arena 入面嘅 7 個,重構 9:0、除錯 6:1。Fable 5 唯一贏嘅一項係「速度」。
- Artificial Analysis 智能指數(九項獨立評測綜合,0-100 分):K3 攞 57,Fable 5 60、GPT-5.6 Sol 59、Opus 4.8 56。K3 排第三,同榜首爭 3 分。
另外 Artificial Analysis 嘅私有長時程知識工作評測,K3 攞 Elo 1,547 — 比 K2.6 勁升 732 分,只輸畀 Fable 5。
K3 一啲都唔平 — 呢個先係最多人搞錯嘅嘢
成個市場恐慌嘅邏輯係:「中國又出咗個平價殺手,美國嘅算力優勢冇晒價值。」
從數據嚟睇,呢個講法有一半唔成立。
$0.30 / $3 / $15 呢組價,同 Claude Sonnet 5 完全一模一樣。唔係四捨五入接近,係逐個位一模一樣。
對返自己上一代 K2.6($0.95/$4):input 貴咗 3.16 倍,output 貴咗 3.75 倍 — 加價最狠嘅係 output,而 output 正正就係推理型模型燒得最多嘅嗰邊。如果再對返一年前嘅 K2($0.60 input),未 cache 嘅 input 貴咗足足五倍。呢個係中國實驗室有史以來定價最貴嘅模型。
對照返 DeepSeek:V4 而家 output 收 $0.87 一百萬 token。K3 收 $15 — 係 DeepSeek 嘅十七倍。今年年初中美前沿模型之間嘅價差係 15 至 30 倍,K3 直接主動放棄咗呢個優勢。
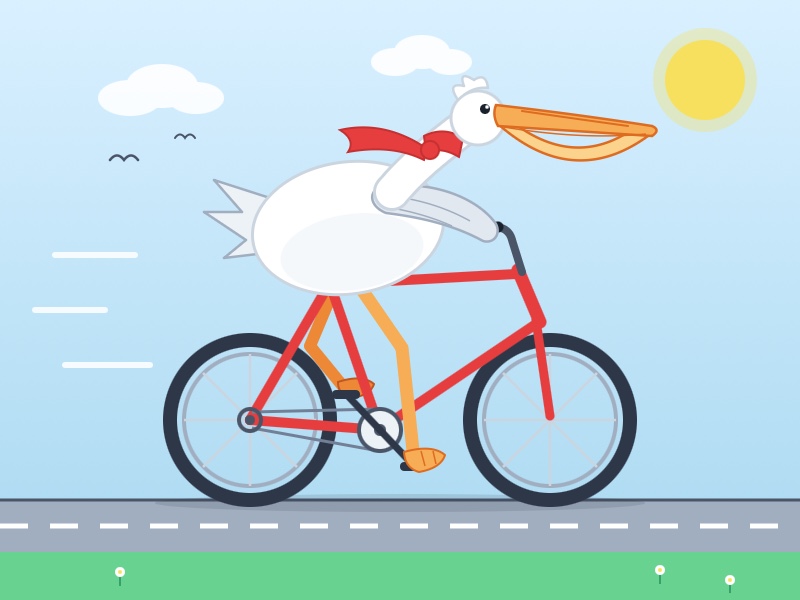
實測更加講明問題。獨立開發者 Simon Willison 用一句 prompt 叫 K3 畫隻「鵜鶘踩單車」嘅 SVG,結果燒咗 16,658 個 output token(其中 13,241 個係推理 token),單次成本 25 美仙。原因係 K3 目前只有一檔推理強度 — 就係「max」,你想慳都慳唔到。
因為要睇「每項任務成本」而唔係 token 單價。Artificial Analysis 計出嚟:K3 每項任務 $0.94、GPT-5.6 Sol $1.04、Opus 4.8 $1.80。K3 用少 21% output token 就做到同級工作。
而 Fable 5 嘅 output 收 $50 一百萬 token — K3 只係佢嘅三成。
所以準確講法係:K3 唔係「平價殺手」,佢係「中價位攞到接近頂級表現」。呢個對客戶好緊要,但同「AI 從此變平」係兩碼子事。
呢個定價決定其實好講嘢。月之暗面大可以照舊劈價搶份額,但佢冇 — 佢揀咗貼住 Sonnet 5 收錢。呢個係一間覺得自己終於有議價能力嘅公司先會做嘅事。
換句話講,如果你係因為「AI 推理價格要崩」而沽半導體,你嘅前提本身就唔成立。
L20 同 H200 — 真正應該擔心嘅係呢度
市場驚錯咗方向,唔代表冇嘢好驚。真正嘅問題埋喺技術文件嘅註腳入面。
Moonshot 嘅 kernel 優化 benchmark,係喺 Nvidia H200 同埋一個佢只肯叫做「來自另一家供應商嘅 GPGPU」上面跑 — 佢冇講明係邊間,業界普遍估係華為昇騰。而佢自研嘅 MiniTriton 編譯器(由零寫起,對標 Triton),圖表對比用嘅係 Nvidia L20 — 即係美國出口管制之下,特別閹割咗賣入中國嘅 Ada 架構卡。
Moonshot 亦都承認過,早期模型係用 H800 訓練嘅 — 嗰款卡 2023 年底已經被禁止出口中國。
Moonshot 嘅 blog 冇講嗰啲 H200 放喺邊度。美國國會今年 1 月先至通過法案,堵塞「離岸雲端租用」漏洞 — 之前中國公司可以透過海外雲服務遠端用受管制加速器。
換句話講,K3 究竟係「純粹靠效率突破」定係「靠海外算力繞道」,目前冇人講得死。呢個係監管風險,亦都係之後政策辯論嘅焦點。
公司背景值得香港投資者留意。月之暗面 2023 年 3 月成立,創辦人楊植麟今年 34 歲,清華同學仔一齊創業,佢本人喺 CMU 四年讀完博士,做過 Meta 同 Google。公司名出自 Pink Floyd 嘅《The Dark Side of the Moon》— 佢最鍾意嗰隻碟。
股東名單:阿里巴巴、騰訊、美團,加上 HSG(前紅杉中國)。今年 5 月融資 20 億美元,估值超過 200 億美元。而且據報正考慮喺香港 IPO。
月之暗面總裁張宇韜喺今年達沃斯講過一句,而家聽返好有意思:
「我哋知道自己冇奢侈到可以淨係堆算力。呢個逼我哋專注喺基礎研究同效率上面。」
美銀證券(分析員 Alex Liu)喺發布後嘅報告寫得更加白:K3 證明咗「大規模預訓練配合架構創新,喺算力受限之下仍然可以帶嚟階躍式進步」。
再睇埋周邊:美團上個月推出嘅 LongCat 2.0,係完全用中國國產晶片訓練出嚟嘅 1.6 萬億參數模型。OpenRouter 呢個星期最多人用嘅頭五個模型,全部係中國公司 — 騰訊、小米、DeepSeek、MiniMax、z.ai。7 月 17 日習近平喺上海 WAIC 亦都重申會繼續行開源路線。
市場驚嘅:中國模型變到好平,推理價格要崩,AI 硬件需求會塌。→ 數字唔支持,K3 反而加咗價。
真正值得驚嘅:出口管制作為護城河,可能冇想像中咁有效。如果閹割版硬件加演算法效率就追得到前沿,咁「用錢同晶片砌出領先」呢個假設就要重估。→ 呢個係結構性,唔係一日行情。
投資部署 — 同一個 Jevons 悖論嘅老問題
喺落任何決定之前,有一組數字值得擺喺枱面。
K3 官方建議部署喺 64 個或以上加速器嘅 supernode,目的係將專家並行嘅流量鎖喺同一個高頻寬域入面。Decrypt 講得更加直接:「目前冇任何一款國產 GPU,無論幾大,處理得到呢個尺寸嘅模型。」
再加上單次推理隨時燒一萬幾千個推理 token — 訓練效率提升,唔等於總算力需求下降。呢個就係經典嘅 Jevons 悖論:蒸汽機效率越高,煤炭消耗反而越多,因為用途爆炸式增加。
| 板塊 / 標的 | K3 帶嚟嘅影響 | 點睇 |
|---|---|---|
| NVDA 輝達 | 中國市場需求結構改變,但推理側需求未見萎縮 | 叙事受壓,基本面未變 — 留意佢喺中國嘅收入佔比披露 |
| TSM / 2330 台積電 | Q2 營運利潤 +77%,capex 上調 14% 至 $640 億 | 業績同股價背馳,市場而家 punish capex 而唔係獎勵 |
| SMH 半導體 ETF | 跌穿 50 日線,已入熊市區 | Jefferies 指超賣比例未到賣壓耗盡水平 |
| 9988.HK 阿里 / 0700.HK 騰訊 / 3690.HK 美團 | 三間都係月之暗面股東,同時各自有自家模型 | 中國 AI 曝險嘅間接途徑,估值遠低於美股同業 |
| Moonshot IPO(傳) | 據報考慮香港上市,5 月估值逾 $200 億 | 港股稀缺嘅純前沿 AI 標的 — 值得長期跟進 |
| 記憶體(SK Hynix / 三星) | 南韓交易所 7/17 假期休市,反應要落星期一先睇到 | HBM 需求同模型尺寸正相關,K3 咁大反而可能係利好 |
1. 幻覺率大幅惡化。K3 喺 AA-Omniscience(量度模型幾常自信咁作嘢)嘅幻覺率,由 K2.6 嘅 39% 升到 51%。答啱嘅多咗,但作嘅都多咗。Moonshot 自己文件亦承認模型可能「過度主動」,喺長時間自主任務入面代用戶做非預期決定。
2. 官方 benchmark 要打折。完整權重 7 月 27 日先釋出,喺嗰之前所有數字都未經第三方完整覆核。
3. 算力來源未明。H200 擺喺邊度冇交代,如果之後證實涉及離岸租用漏洞,可能引發新一輪管制。
4. 宏觀環境本身就差。伊朗停火破局、美軍連續空襲、能源價格同通脹壓力,加上 Fed 主席 Warsh 鷹派轉向 — 市場當日由風險偏好轉去避險模式,K3 只係點火嗰下。
5. 技術面未見底。Jefferies 指符合「超賣」條件嘅半導體股比例,距離賣壓耗盡水平仲有一段距離。
我哋睇返個 timeline:去年 DeepSeek 抹咗科技股 1 萬億市值,之後半導體照升,上半年仲創咗史上最佳表現。
呢次唔同嘅地方唔喺價錢,喺「用受限硬件追到前沿」呢件事本身。7 月 17 日嗰波拋售,好可能係啱嘅方向、錯嘅理由 — 而個 gap,就係之後幾個月最值得跟嘅嘢。